AIによる無断スクレイピングや学習への対策を、「アクセスを拒否する」のではなく文字そのものの見せ方を変えることで実現しようとする試みが広がっています。
- 人間とAIに異なる文字を見せる「Decoy Font」
- 動きの中に文字を隠す「Ghost Font」
- Webページのソースと画面上の表示を分離する「ShieldFont」
いずれも万能な防御策ではありませんが、robots.txtや利用規約とはまったく違う方向から、AI時代の「読ませる相手を選ぶ」という問題に踏み込んでいます。米Smithsonian Magazineも9月11日、こうした“anti-AI font”の動きを取り上げました。
同じ文字なのに、人間とAIで違って見える「Decoy Font」

Mixfontが公開している「Decoy Font」は、人間とAIの視覚認識の差を利用した実験的なフォントです。
1文字の中に、細く輪郭のはっきりした高周波の形と、ぼかされた低周波の形を重ねます。近くから細部を見る場合と、少し離れて全体を見る場合で認識しやすい形が変わる「ハイブリッドイメージ」と呼ばれる錯視の考え方をタイポグラフィへ応用したものです。
人間には本来のメッセージが読める一方、画像として文字を解析するAIには別の「おとり」の文字を認識させる仕組みです。
Mixfontのデモでは、入力した「Hidden message」と「Decoy message」を同じ文字空間へ重ねられます。実際にインストール可能なTTFファイルも公開されており、画像だけのコンセプトではなくフォントとして試せます。
個人利用、商用利用、クライアントワークでも利用できるとされています
これまで画像や文章のAI対策というと、
- 透かしを入れる
- アクセスを遮断する
- 規約で学習を拒否する
といった方法が中心でした。
Decoy Fontでは、「AIには読める。でも読んでいる内容が違う」状態をデザインによって作ろうとしています。
つまりタイポグラフィが、情報を伝えるためのデザインだけでなく、情報へアクセスする主体を分ける仕組みにまで入り始めています。
ただし「AIに絶対読めないフォント」ではない
高度なAIエージェントが仕組みを理解したり、「隠れている文字を探して」と適切に指示されたりすれば、本来の文字まで解析される可能性があります。
Mixfont自身も、Decoy Fontによる保護を保証していません。
そのため、機密情報の暗号化に使えるような技術ではありません。
現時点のAIにとって最初の認識を難しくしたり、大量の画像を機械的に処理するスクレイピングのコストを上げたりするための実験、と考えた方が近いでしょう。
「動き」を利用してAIの認識を外すGhost Fontも

Mixfontはさらに「Ghost Font」という別の実験も公開しています。
こちらは一般的なTTFフォントとは違い、動画内を動くドットによって、人間だけが文字の形を認識しやすくする仕組みです。静止した1フレームだけを見ると文字はほぼ消えてしまい、動きを追うことで文字が浮かび上がります。
現在のマルチモーダルAIは、動画を複数の静止フレームとして解析する場合があります。Ghost Fontはその弱点を利用し、人間の「動きを連続して見る能力」とAIの画像解析方法の違いを突いています。
さらにデコイとなる情報も混ぜることで、解析しようとしたAIが別のメッセージを本物だと判断する仕掛けも入れられています
とはいえ、こちらも永久に通用する方法ではありません。動画そのものを時間軸で理解するAIが進化すれば、この差はいずれ縮まる可能性があります。
むしろGhost Fontは「AIには何が見えていて、人間には何が見えているのか」を測るベンチマークとして見ても興味深い存在です。
ShieldFontは発想が違う。AIには「別の文章」を渡す
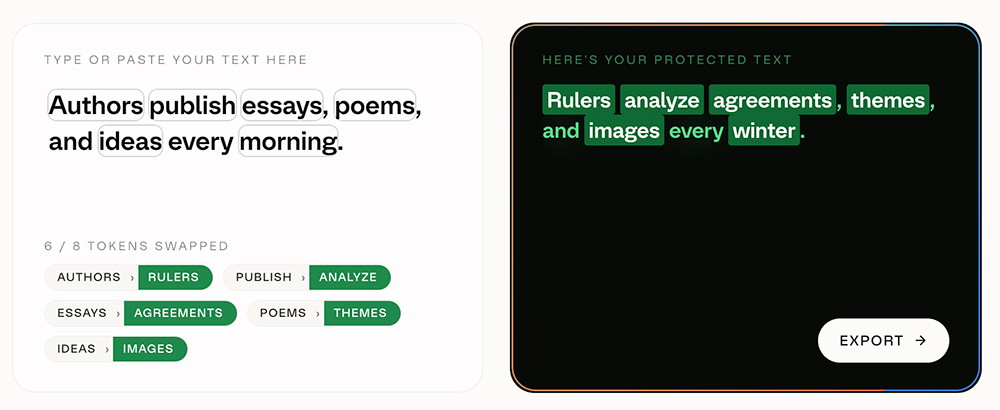
Decoy FontやGhost Fontが視覚認識を利用するのに対し、「ShieldFont」はWebの仕組みそのものを利用します。
こちらは画面に表示される文字を読みにくくするフォントではありません。
WebページのHTMLには本来とは異なる単語を保存しておき、フォントの「リガチャ」と呼ばれる文字置換機能を利用して、ブラウザ上では本来の文章を表示するというものです。
リガチャは「fi」など特定の文字列を一つの字形として表示する、一般的なフォント機能です。ShieldFontはこの仕組みを単語単位へ広げています。
たとえばソースコード上に「engine」という単語が入っていても、フォント側の置換ルールによって画面では「horse」の形を表示するといったことができます。人間はブラウザが描画した文章を見る一方、大量収集を行うスクレイパーはHTML側の異なる文章を取得する、という考え方です。
ShieldFontのテストでは90%超が品質フィルターから脱落
ShieldFontのホワイトペーパーによると、現在の仕組みではコンテンツ語の45.8%、文章全体では約24.4%の単語が別の単語へ置き換えられます。
プロジェクト側のテストでは、本来ならAI学習用データとして品質フィルターを通過するページのうち、90%超がShieldFont適用後にフィルターから除外されたと報告されています。通過したデータについても、全単語の19.4%が本来とは異なる意味を持つ状態になったとしています。
ここで重要なのは、「AIが文章を取り込んだ瞬間に学習できなくなる」仕組みではないことです。
収集された文章そのものの品質を落とし、AI学習用データとして使いにくくする。
ShieldFontが狙っているのはこちらです。
一件ずつ狙われれば突破できても、数億ページを収集するような大規模スクレイピングで、サイトごとにフォントを解析して元の文章を復元するとなれば処理コストが増えます。
「完全に隠す」よりも「勝手に集める方を面倒にする」という設計思想に近いでしょう。
ShieldFontにも大きな弱点がある
便利そうに見えますが、現状では一般的なWebサイトへ気軽に導入できる技術ではありません。
最大の問題はSEOです
検索エンジンも基本的にはページのソースを読み取るため、ShieldFontで置換した文章をGoogle側にも読ませることになります。ShieldFont自身も、検索順位を取りたい文章には使用しないよう明記しています。
アクセシビリティにも課題があります。
スクリーンリーダーは画面に描画された字形ではなくHTMLを読むため、そのままでは本来と違う文章を読み上げてしまいます。現在のReact版では対象領域をaria-hiddenで隠し、別途本来の文章を復号する仕組みが用意されていますが、プロジェクト自身もWCAG準拠などが求められるコンテンツへの使用を推奨していません。
さらに翻訳ツール、コピー&ペースト、検索などにも影響があります。現在の辞書も英語が中心です。
つまり、普通のブログ記事すべてをShieldFont化するような使い方は現実的ではありません。
「拒否する」から「収集する価値を下げる」へ
AI学習を拒否する意思表示としては、robots.txtなど既存の方法があります。
ShieldFontも、それらを置き換えるのではなく併用することを推奨しています。
それでも今回の一連の試みは、クリエイターにとってかなり示唆的です。
AIとクリエイターの問題はこれまで、「学習してよいか」「学習してはいけないか」というルールの議論が中心でした。
ところがDecoy FontやShieldFontは、「無視して取りに来るなら、AIが欲しい形では渡さない」という技術側からのアプローチを持ち込んでいます。
Webサイトには人間、検索エンジン、AIエージェント、スクレイパーが同じ入口からアクセスしています。今後は「誰に何を見せるか」をコンテンツ側が細かく制御する技術が、デザインやWeb制作の新しい領域になっていくかもしれません。
少なくともフォントは、文字の雰囲気を決めるだけの存在ではなくなりつつあります。
